
Technical SEO คืออะไร?
เข้าใจการเก็บข้อมูล การจัดทำดัชนี Canonical การแสดงผล และการย้ายเว็บ โดยไม่สับสนกับคำรับประกันอันดับ
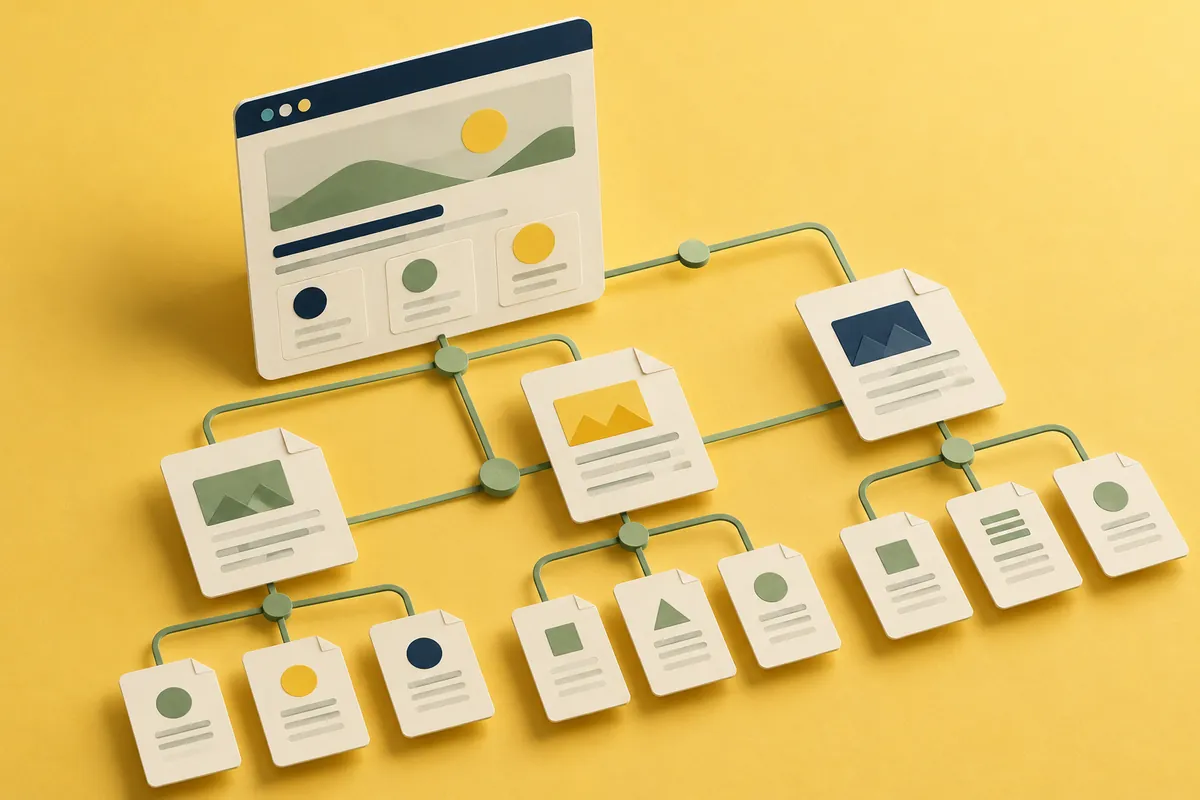
Technical SEO ช่วยให้เครื่องมือค้นหาเข้าถึงและตีความหน้าที่ตั้งใจเผยแพร่ ไม่สามารถทำให้หน้าที่ไม่ตอบโจทย์มีประโยชน์หรือรับประกันอันดับ ต้องแยกการค้นพบ URL การเก็บข้อมูล การจัดทำดัชนี และการแสดงผล การผ่านขั้นหนึ่งไม่ได้รับประกันขั้นถัดไป
ตรวจว่าหน้าสำคัญเข้าถึงได้จริง
ตรวจ HTTP Response และเนื้อหาที่แสดง หน้าสาธารณะไม่ควรต้องให้ผู้ใช้กดก่อนจึงเห็นคำอธิบายหลัก ตรวจ URL ที่ไม่มีอยู่ให้ตอบสถานะหน้าหายอย่างเหมาะสม ไม่แสดงหน้าสำเร็จที่ไม่เกี่ยวข้อง
แยก Robots กับ Noindex
Robots ควบคุมสิทธิ์เข้ามาเก็บข้อมูล ส่วน Noindex ขอไม่ให้จัดทำดัชนีและตัวเก็บข้อมูลต้องอ่านพบ การปิดใน robots.txt ไม่เหมือนการลบจากผลค้นหา อย่าคิดว่าเครื่องมือจะอ่าน Noindex บนหน้าที่ห้ามเข้าได้
ระบบ Preview ต้องตั้งการป้องกันอย่างตั้งใจ ตรวจระบบที่เปิดใช้จริง ไม่ถือว่าค่าตั้งเหมือน Build ในเครื่องเสมอ
ส่งสัญญาณ URL ให้สอดคล้อง
Canonical ควรอ้างตัวเองบนโฮสต์จริง เชื่อมภาษาคู่กันเฉพาะหน้าที่มีอยู่ Sitemap ควรมีปลายทางจริงที่เปิดให้ Index ไม่ใช่ Draft, Redirect หรือหน้าที่จะทำในอนาคต สัญญาณเหล่านี้ช่วยตีความ แต่ไม่ได้บังคับให้ Index ทุก URL
ลำดับตรวจที่ทำตามได้
- ยืนยันว่าโดเมนจริงแสดง Deployment ที่ต้องการ
- ตรวจ Robots, คำสั่ง Index ของหน้า และ Response Header
- ตรวจ Canonical และปลายทางต่างภาษา
- เทียบ URL ใน Sitemap กับหน้าที่ตอบสำเร็จจริง
- ตรวจลิงก์ภายใน การแสดงเนื้อหา และประสิทธิภาพส่วนสำคัญ
รักษา URL เมื่อเปลี่ยนเว็บ
เก็บ URL ที่มีประโยชน์ถ้าทำได้ หน้าที่ย้ายควรส่งตรงไปเนื้อหาทดแทนที่เทียบเท่า ไม่ส่งทุกอย่างไปหน้าแรก บันทึกหน้าที่ตั้งใจลบและติดตามหลังเปิดใช้ อ่าน พื้นฐาน Search Console เพื่อดูรายงานของ Google แต่ความพร้อมทางเทคนิคกับการถูก Index เป็นคนละเรื่อง
แหล่งข้อมูลและอ่านต่อ
- How Search works — Google
- Block indexing with noindex — Google
- SEO Starter Guide — Google Search Central
ตัวอย่างและกรอบตัดสินใจเป็นแนวทางประกอบการวางแผน ไม่ใช่ผลลัพธ์ที่รับประกัน ตรวจเงื่อนไขผู้ให้บริการก่อนนำไปใช้จริง
บทความที่เกี่ยวข้อง
ดูทั้งหมด →
SEO และการเติบโตดิจิทัล
เริ่มทำ SEO สำหรับเว็บไซต์ธุรกิจอย่างไร?
วาง SEO จากคำถามลูกค้า หน้าบริการที่มีประโยชน์ การเข้าถึงทางเทคนิค และคำถามติดต่อที่วัดได้
2 นาทีโดยประมาณ
SEO และการเติบโตดิจิทัล
ใช้ Google Search Console ตรวจเว็บไซต์อย่างไร?
ใช้รายงานประสิทธิภาพ ตรวจ URL และ Sitemap โดยแยกข้อมูลย้อนหลังออกจากสถานะปัจจุบัน
3 นาทีโดยประมาณ
SEO และการเติบโตดิจิทัล
ทำความเข้าใจ Core Web Vitals
อ่าน LCP, INP และ CLS ให้ถูก แยกข้อมูลจริงกับห้องทดสอบ และเลือกแก้จุดที่สำคัญ
2 นาทีโดยประมาณ